Проверка Канбан-системы: как оценить здоровье потока раз в месяц
Как провести ежемесячную проверку Канбан-системы: оценить путь задачи, очереди, незавершённую работу, сроки и качество, затем выбрать одно улучшение.

Канбан-доска может выглядеть аккуратно и при этом плохо помогать работе. Карточки двигаются, встречи проходят, но заказчик не понимает срок, очередь растёт, а зависимые решения всплывают в последний день. Периодическая проверка Канбан-системы позволяет увидеть такие расхождения до того, как команда привыкнет считать их нормой. Если очередь стабильно растёт перед одним этапом, примените теорию ограничений к этому потоку.
Проверять нужно не красоту колонок, а способность системы принимать запрос, доводить его до результата и учиться на задержках. Раз в месяц соберите несколько фактов о спросе, незавершённой работе, сроках и качестве поставки. Затем выберите одно изменение правила и проверьте его эффект. Так аудит остаётся рабочим инструментом, а не отдельным отчётом ради отчёта.
Начните с цели сервиса
Спросите, кому команда оказывает услугу и что её получатель считает завершённым результатом. Внутренний отдел может принимать заявки на аналитические отчёты, поддержка — решать обращения, продуктовая команда — поставлять работающие сценарии. Для каждого сервиса нужна своя граница начала и конца. Одна общая доска нескольких разных потоков часто скрывает, где именно обещание нарушается.
Сверьте формулировку сервиса с реальными карточками последнего месяца. Если половина работы относится к срочным внутренним просьбам, а доска настроена только под плановые изменения продукта, описание устарело. Не обязательно создавать отдельную систему для каждого типа. Но нужно видеть различия в спросе, пути и ожиданиях по сроку.
Уточните, кто принимает решения на границе сервиса: выбирает новые запросы, меняет приоритет и подтверждает результат. Если эти роли размыты, метрики не заменят управленческого решения. Хорошая проверка обнаружит такую неопределённость, а не сведёт всё к настройке ещё одной колонки.
Соберите на встрече не только команду исполнения. Человек, который приносит запросы, и тот, кто принимает поставку, видят разные части пути. Если они не могут присутствовать, запросите несколько конкретных примеров до встречи. Это поможет избежать внутреннего самоуспокоения: доска может выглядеть быстрой для исполнителей, пока клиент ждёт решения на невидимой границе.
Проверьте, соответствует ли доска реальному пути работы
Возьмите несколько завершённых и несколько открытых задач. Проследите, какие события происходили между появлением запроса и приёмкой. Совпадают ли они со столбцами доски? Если значительная часть ожидания живёт в комментариях, личной переписке или статусе «В работе», картина потока неполна.
Не стремитесь отразить каждый жест отдельным столбцом. Колонка полезна, если переход через неё меняет ответственность, критерий проверки или правило вытягивания следующей работы. Иначе доска обрастёт деталями, которые не помогают решать проблемы. Проверяйте также, не превратился ли один столбец в склад всего, чему не нашлось места.
Особое внимание уделите началу и концу. Непонятная точка принятия обязательства создаёт разные ожидания у заказчика и команды. Закрытие карточки до реальной приёмки улучшает видимый срок, но не ускоряет результат. Запишите границы так, чтобы новые участники могли объяснить их одинаково.
Проверьте и переходы между командами. Карточка может исчезать с одной доски и появляться на другой под новым названием, отчего общий путь кажется короче. Достаточно связать записи и назвать ответственных с обеих сторон. Не обязательно объединять все доски в одну: важно иметь возможность восстановить путь конкретной поставки и увидеть время между передачей и фактическим началом следующего этапа.

Посмотрите на возраст текущих задач
Средний срок завершённых задач не показывает элемент, который застрял прямо сейчас. Отсортируйте открытые карточки по времени с момента старта и разберите самые старые. Чем они отличаются от обычной работы? Не хватает входных данных, ожидается решение, задача выросла после начала или исполнитель переключился?
Для каждого долгого элемента назначьте следующий проверяемый шаг. Иногда нужно помочь завершить почти готовую работу, иногда — уточнить границу результата и разделить её, иногда — честно пересмотреть обещание. Не меняйте дату начала карточки, чтобы она выглядела свежей. История возраста нужна именно для раннего предупреждения.
Сравните открытые задачи с историей похожих завершений. Если задача уже прожила дольше большинства аналогичных, это повод обсуждать риск, даже если формальный дедлайн ещё далеко. Подробный разбор задержек задач с ИИ может помочь найти общий мотив, но решение принимайте после проверки реальных причин.
Сверьте незавершённую работу с мощностью команды
Подсчитайте, сколько элементов одновременно находится после точки начала и до завершения. Проверьте, работают ли установленные WIP-лимиты: помогают ли они закончить начатое или их регулярно обходят через скрытые списки и пометки «временно». Если лимит превышен, обсуждайте почему. Возможно, команда принимает срочные запросы без правила замещения, а возможно, границы столбцов не соответствуют работе.
Не оценивайте состояние только по числу карточек. Один крупный элемент может занять больше мощности, чем несколько типовых. Посмотрите на роли и узкие места: проверяющий может быть перегружен, когда исполнители свободны. При этом не превращайте аудит в сравнение персональной производительности; вопрос состоит в устойчивости всего потока.
Если каждая блокировка становится поводом начать новую задачу, система постепенно теряет предел незавершённой работы. Проверьте, сколько карточек возвращается к исполнению после снятия препятствия и с какой работой они сталкиваются. Уточните правило исключений, прежде чем просто увеличить лимит.
Спросите участников, что происходит, когда лимит достигнут. Хороший ответ — помочь завершить начатое, снять препятствие или обсудить осознанное исключение. Плохой признак — создавать скрытую копию карточки в личном списке, чтобы доска выглядела в норме. Такой обход не виноват в проблеме сам по себе; он показывает, что существующее правило не помогает людям управлять реальной нагрузкой.
Разберите очереди и повторяющиеся препятствия
Посмотрите, перед какими этапами накопилось больше всего задач и как долго они там ждут. Очередь перед согласованием может означать редкие встречи, неполные входные данные или слишком большой объём, передаваемый на проверку. Причину не покажет одно число на столбце — нужны примеры конкретных карточек и разговор с участниками.
Сгруппируйте блокировки по причинам и суммарному времени. Частая короткая остановка и редкая очень дорогая требуют разных мер. В первом случае может помочь шаблон запроса; во втором — резервный маршрут или раннее решение руководителя. Выбирайте изменение по последствиям для поставки, а не по тому, какой столбец выглядит хуже на снимке доски.
Посмотрите, не перенеслось ли ожидание после прошлого улучшения. Если команда ускорила разработку, но проверка осталась прежней, общая поставка может не ускориться. Периодический обзор должен охватывать весь путь результата, включая внешние переходы, а не только участок одного отдела.
 Очереди полезно проверять по времени ожидания и конкретным карточкам.
Проверьте предсказуемость срока
Соберите время прохождения завершённых элементов одного типа и сравните с тем, что команда обещала заказчикам. Сколько поставок уложилось в выбранное ожидание, а сколько существенно вышло за него? Обсуждайте не только среднее. Несколько очень долгих случаев могут быть именно тем, что разрушает доверие, хотя типичная задача выглядит быстрой.
Проверьте, не изменились ли условия: размер карточек, состав команды, входящий спрос, процедура приёмки. Если изменились, старые обещания нужно пересмотреть. Предсказуемость — не запрет на сюрпризы, а способность заранее назвать честный диапазон и заметить отклонение, пока ещё остаётся время для решения.
Следите и за пропускной способностью. Если входящий поток стабильно больше выхода, очередь будет расти даже при хорошем времени отдельных задач. Для заказчика это проявится ожиданием до старта. Показатель throughput и время прохождения нужно читать вместе, не выбирая один удобный график.
Проверьте сроки по разным типам работы. Срочные инциденты часто проходят быстро, а плановые улучшения месяцами ждут. Общая медиана может улучшаться за счёт увеличения доли быстрых обращений, хотя состояние длинных проектных задач ухудшается. Разделение по типам и короткий просмотр нескольких старых карточек не дадут такой смене состава потока спрятаться за общей цифрой.
Посмотрите на качество результата и возвраты
Быстрое движение карточек мало значит, если результаты регулярно возвращаются на переделку. Отметьте, какие задачи открывались снова, где обнаружили ошибку и какой критерий не был понятен заранее. Возможно, проверка с заказчиком проходит слишком поздно или команда закрывает карточку до того, как результат можно использовать.
Не превращайте возвраты в повод искать виновного. Обсуждайте, какое правило входа, промежуточной проверки или передачи могло обнаружить расхождение раньше. Если исправление системное, оно может временно увеличить активное время на задачу, но сократить общий путь до принятого результата.
Спросите получателей сервиса, что в работе команды остаётся непредсказуемым. Метрики не всегда заметят путаницу в коммуникации или отсутствие понятного владельца решения. Несколько конкретных случаев полезнее формального опроса с общей оценкой «удовлетворён».
Проверьте правила, которые никто уже не помнит
У любой Канбан-системы есть правила: что означает колонка, кто может ускорить срочную задачу, когда элемент считается готовым, как разбирают блокировки. На аудите попросите разных участников объяснить их без подсказки. Если ответы различаются, правило либо плохо сформулировано, либо не соответствует ежедневной работе.
Удалите правила, которые больше не помогают, и уточните те, по которым возникают споры. Не переписывайте всю систему за одну встречу. Выберите одно существенное изменение, назначьте владельца и дату проверки. Сохраните старую формулировку и причину правки, чтобы через месяц можно было понять результат эксперимента.
Ритм обзоров тоже важен. Канбан-каденции дают разные места для ежедневных препятствий, пополнения очереди и улучшения сервиса. Ежемесячная проверка не должна повторять ежедневную встречу по всем карточкам; её задача — изменить правило системы там, где отдельные напоминания уже не работают.
 Аудит завершается изменением одного правила и проверкой его эффекта.
Проведите аудит на одном примере
Команда ведёт запросы на аналитику. На доске пять столбцов, WIP-лимит соблюдается, а большинство карточек закрывается за четыре дня. Кажется, что всё в порядке. Но три последних отчёта заказчик получил через две недели: ещё до старта они долго лежали без уточнения данных, а после выполнения ждали проверки раз в неделю.
На обзоре команда меняет не число столбцов, а два правила. Входящий запрос получает владельца уточнения и дату решения о запуске. Проверку готового результата согласуют с заказчиком при принятии задачи, а не в день окончания. Через месяц сравнивают полный срок от обращения до принятого отчёта и нагрузку проверяющего.
Если срок сократился без роста переделок, изменение закрепляют. Если ожидание просто переместилось к другому согласующему, команда ищет следующий узкий участок. Такой разбор показывает, почему нельзя судить о системе по аккуратной доске или одному среднему значению.
Для первой проверки не нужно восстанавливать всю историю сервиса. Возьмите завершения за один месяц и текущие открытые карточки. Отдельно пометьте, какие выводы основаны на наблюдении, а какие пока являются гипотезой. В следующем цикле соберите только те новые данные, которые помогут подтвердить или опровергнуть выбранное изменение. Так аудит останется лёгким и повторяемым.
Завершите проверку конкретным экспериментом
На одну встречу достаточно нескольких фактов: вход и выход, возраст открытых задач, основные очереди, соблюдение правил и отзывы получателей. Выберите одну гипотезу: «если начнём уточнять данные до принятия обязательства, число блокировок после старта снизится». Запишите действие, владельца, срок и способ проверки.
Не пытайтесь получить идеальные метрики до первого улучшения. Начните с доступной истории и честно отметьте пробелы. Сбор данных стоит развивать там, где без него команда не может принять решение. Если каждый месяц вы меняете одно правило и видите последствия, система остаётся живой. Если аудит заканчивается только списком проблем, доска продолжит показывать то же самое через месяц.
После нескольких циклов сравните не только показатели, но и качество разговоров. Стало ли проще объяснить клиенту ожидание по сроку? Меньше ли споров о том, кто должен ответить на вопрос? Быстрее ли команда признаёт, что задача заблокирована? Эти признаки трудно свести к одному числу, но они показывают, работает ли система как общий способ принимать решения.
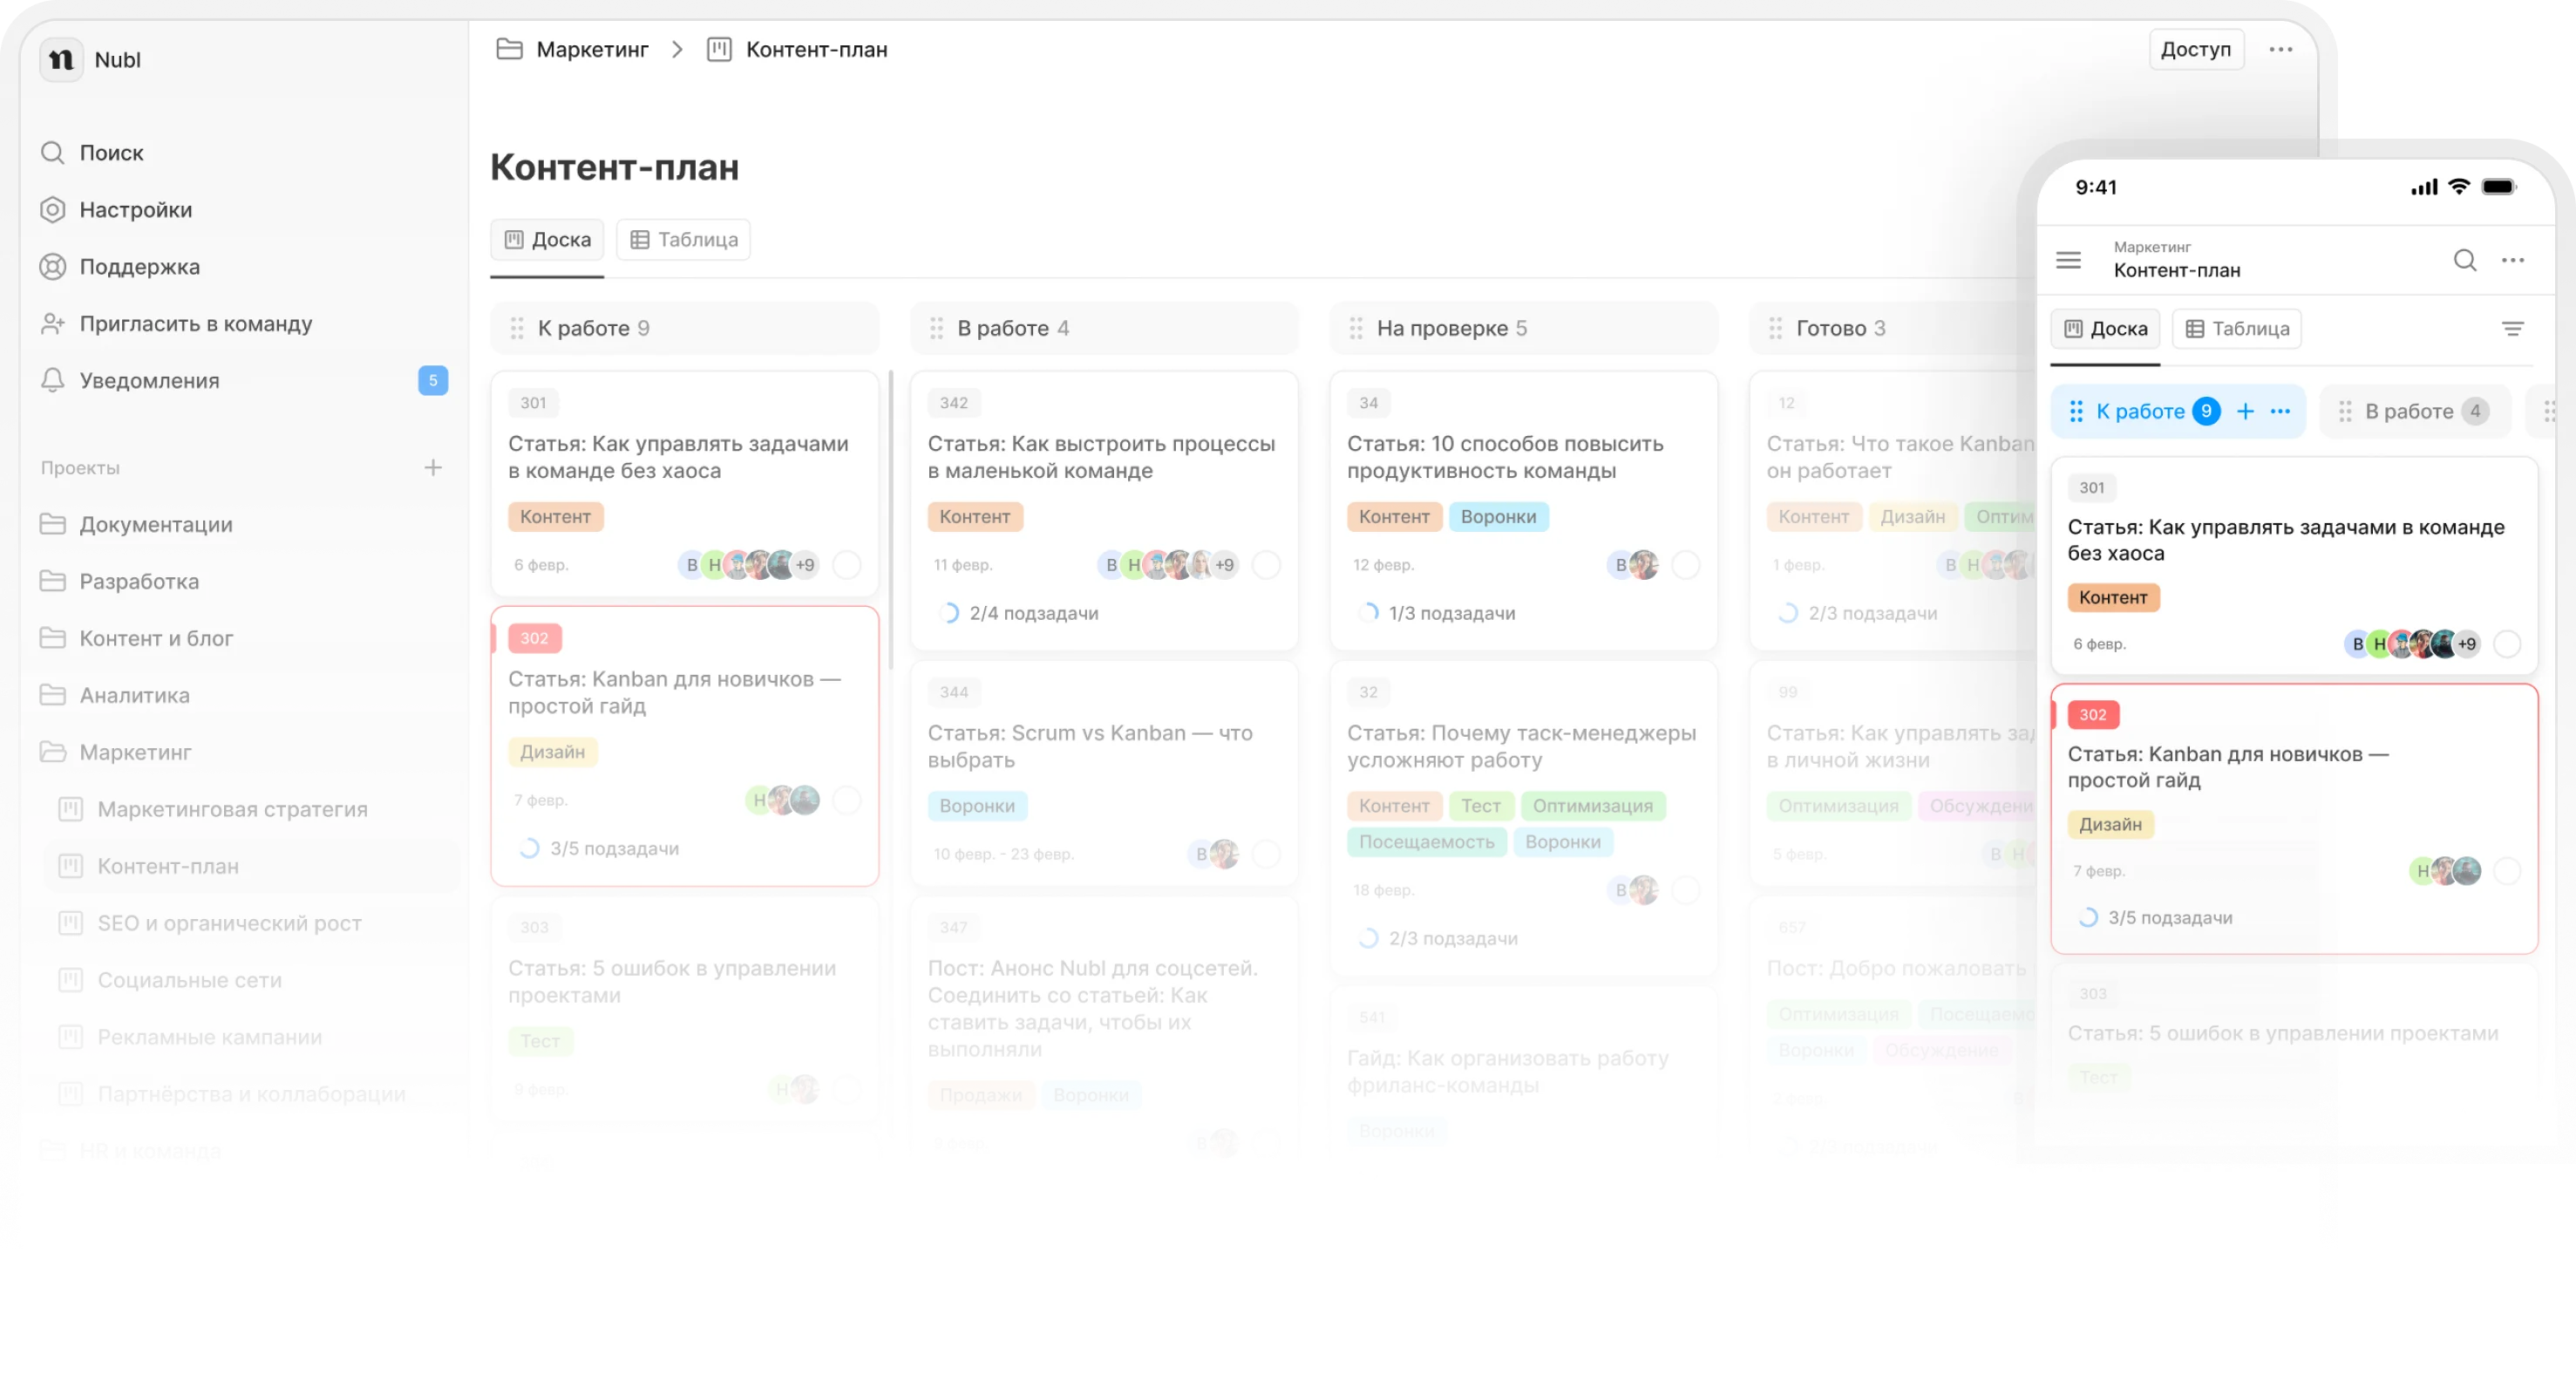
Собери в NUBL историю задач за месяц и проверь, где работа ждёт дольше всего. Выбери одно правило потока для изменения и дату повторной проверки.