Feature-команда или компонентная: как выбрать структуру для разработки
Сравниваем feature-команду и компонентную структуру: где возникают ожидания между группами, какие метрики проверить и как провести пилот без остановки разработки.

Сергей Стародольский

Компонентная команда отвечает за часть системы — например, интерфейс, серверную логику или базу данных. Feature-команда объединяет специалистов разных направлений вокруг пользовательского результата и доводит его от идеи до выпуска. Выбор структуры зависит от работы: если продуктовые возможности постоянно застревают между отделами, кросс-функциональная команда может сократить передачи. Если задача требует глубокой платформенной экспертизы, компонентная группа часто полезнее. Решение стоит принимать по блокировкам и времени доставки результата, а не по моде на организационную схему.
Где компонентная структура помогает и где начинает тормозить
В компонентной модели люди объединены по технической специализации. Одна команда знает интерфейс, другая поддерживает серверную часть, третья отвечает за данные, четвёртая проверяет качество. Каждая глубоко понимает свой слой и получает запросы от соседних групп или менеджера, который координирует общий поток. Такое распределение удобно, когда задачи требуют долгого накопления знаний о конкретном компоненте. О роли и ответственности внутри таких групп мы подробнее писали в материале об управлении командой.
Бэклог технической команды закономерно содержит соответствующие поручения: изменить запрос к базе, обновить часть интерфейса, улучшить API, исправить инфраструктурный процесс. Проблема возникает, если карточка не объясняет пользовательскую цель. Специалист видит свою часть, но не знает, зачем она нужна продукту и насколько срочна относительно других просьб.
Одна пользовательская функция нередко пересекает несколько компонентов. Сначала требуется решение по данным, затем серверный интерфейс, работа на стороне клиента, тестирование и выпуск. Если каждый участок принадлежит отдельной команде со своей очередью, функция ждёт свободного места на каждом переходе. Локально все группы заняты и закрывают задачи. Готового результата для пользователя всё ещё нет.
Эта задержка видна в трекере. Карточки часто получают статус «ждёт другую команду», между проектами растёт сеть связей, а руководитель тратит время на согласование очередей. Не всегда виноват отдельный исполнитель или неверная оценка задачи. Структура заставляет работу проходить через несколько самостоятельных планов, и каждая передача добавляет ожидание. Поэтому полезно заранее определить правила передачи работы между командами с ИИ и подтверждение принимающей стороны.
Но компонентные команды не следует объявлять устаревшими. Инфраструктура, общие библиотеки, платформа, инструменты сборки или дизайн-система обслуживают многие продуктовые потоки. Там полезно единое архитектурное видение и глубокая ответственность за компонент. Аналогично в сложных низкоуровневых областях поверхностное знание всех слоёв может быть опаснее временной очереди к специалисту.
Компонентная модель может быть оправдана и при формальном разделении ответственности. Если для проверки или аудита важно точно видеть владельца технического слоя, границы групп помогают поддерживать эту ответственность. Решение о переходе должно учитывать такие требования наряду со скоростью поставки функций. Не всякая межкомандная зависимость — ошибка; часть из них защищает качество и надёжность общей системы.
Вопрос для руководителя звучит так: какие результаты команда создаёт чаще всего? Если основная работа — независимые технические сервисы для многих команд, специализация естественна. Если основная работа — законченные пользовательские функции, которые постоянно ждут перехода из одной очереди в другую, стоит рассмотреть другую организацию. Причину задержки полезно проверить на данных, а не определять по названию отдела.
Feature-команда отвечает за путь функции целиком
Feature-команда — долгоживущая группа специалистов, которой поручен продуктовый поток. Внутри есть люди с разными навыками, необходимыми для анализа, разработки, проверки и выпуска результата. Команда не собирается на одну короткую задачу и не распускается после релиза: она накапливает знания о пользователях, системе и своих рабочих договорённостях.
Её бэклог написан языком результата. Например, «клиент может скачать отчёт» — пользовательская возможность, а не отдельная задача интерфейса или сервера. Внутри могут быть технические подзадачи по нескольким компонентам, но они принадлежат одному потоку. Ответственность за выпуск функции не растворяется на границах между техническими группами.
Кросс-функциональность не означает, что каждый обязан профессионально заменить любого коллегу. У разработчика может оставаться глубокая специализация, а рядом развивается понимание смежного слоя. Важна способность команды как целого выполнить большинство необходимых действий без длинной очереди внешних передач. Там, где нужна редкая экспертиза, группа обращается к платформенному специалисту и заранее учитывает зависимость.
Постоянство состава помогает видеть эффект собственных решений. Команда не только передаёт «готовый фронтенд» или «проверенный API», но наблюдает, дошла ли функция до пользователя и дала ли ожидаемую пользу. Это меняет разговор о приоритете. Технические улучшения остаются важными, но связываются с надёжностью, скоростью или качеством конкретного продуктового потока.
У feature-модели тоже есть цена. Людям требуется время, чтобы освоить соседние части системы, договориться о стандартах и перестать передавать любую сложность по старой организационной цепочке. Если просто переименовать команды, не изменить бэклог и права на решения, количество ожиданий не уменьшится. Новая схема заработает, когда способ работы действительно позволит доводить функцию до конца внутри группы.
Для выбора полезно сравнить бэклог проекта: если основная очередь разбита по пользовательским фичам, команда может брать их целиком. Если очередь состоит из общих платформенных задач, искусственное деление по продуктовым потокам будет мешать поддерживать единый компонент.

Одна функция на доске: два способа организовать работу
Сравним одну задачу — пользователь должен получать отчёт в удобном формате. В компонентной структуре она распадается на запросы к нескольким группам. Команда интерфейса готовит экран, серверная группа создаёт механизм формирования файла, специалисты по данным проверяют запросы, QA получает результат после объединения частей. Каждая группа хранит свою карточку в собственной очереди.
Менеджеру приходится связывать эти карточки зависимостями и постоянно проверять, где находится общий результат. Интерфейс может быть завершён, пока серверная задача ещё ждёт приоритета. Проверка обнаруживает проблему интеграции и возвращает работу назад. На досках много закрытых пунктов, но главная функция всё ещё не доступна пользователю. Чтобы объяснить её статус, менеджер собирает картину из нескольких пространств.
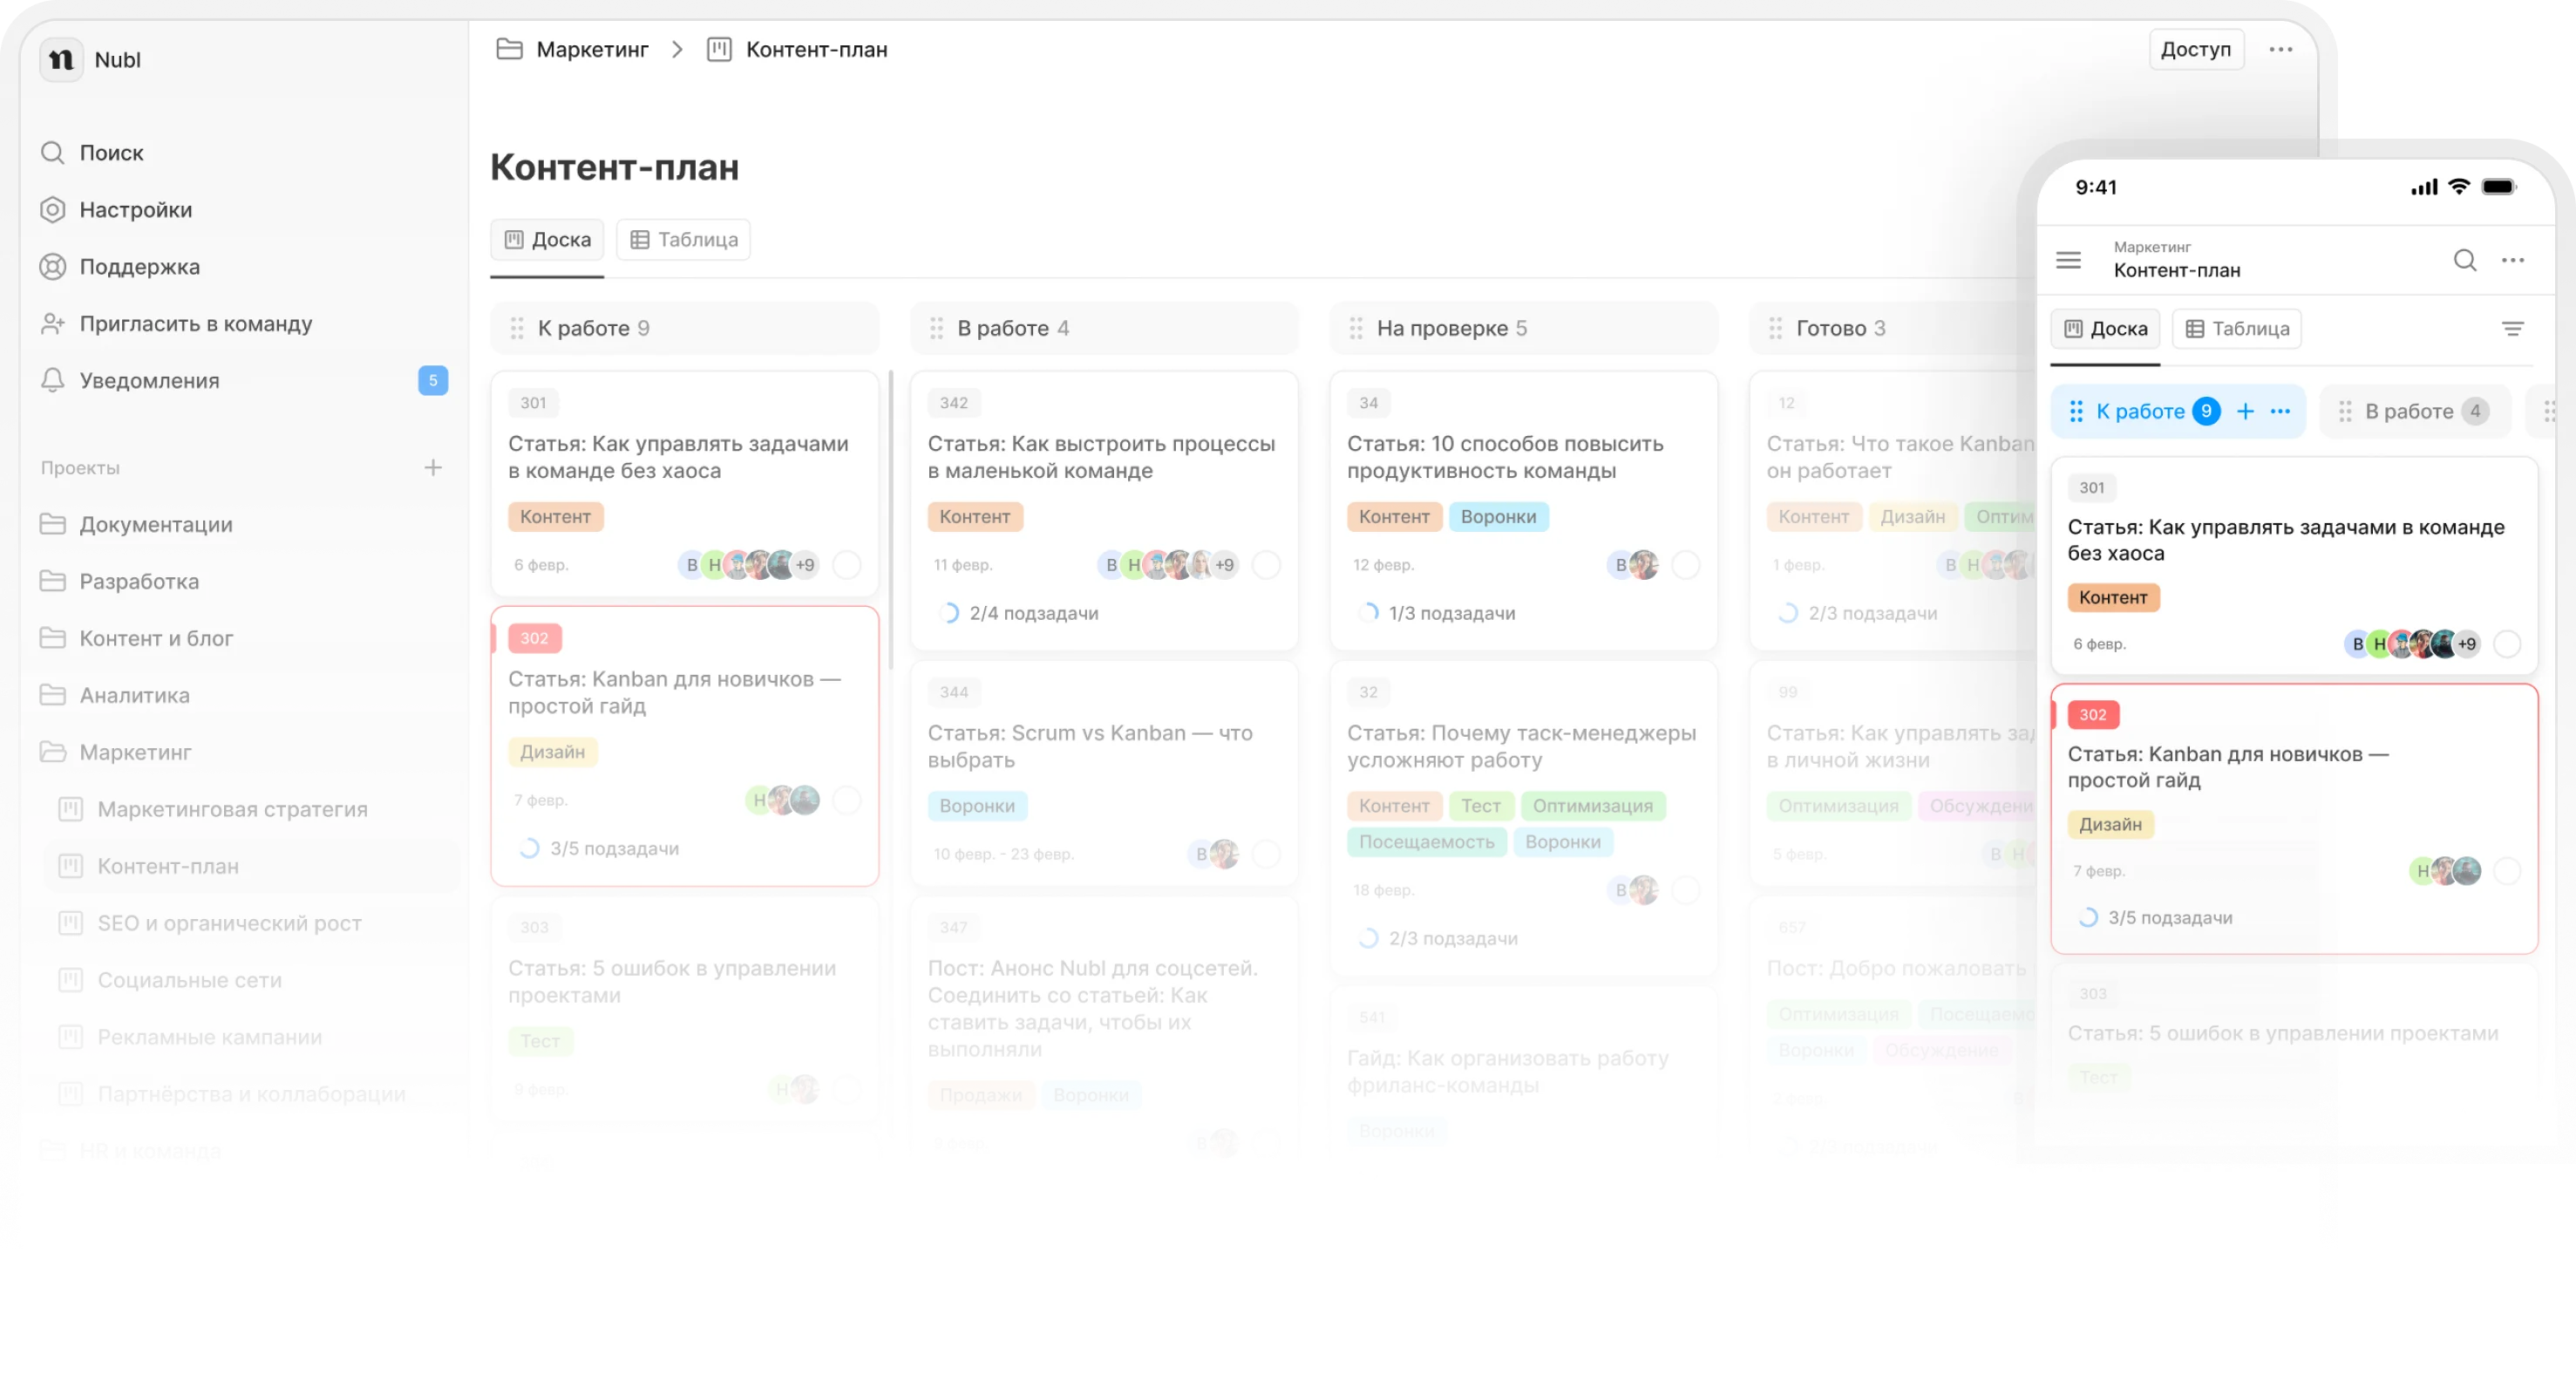
В feature-команде одна карточка описывает пользовательскую возможность, а технические действия находятся внутри неё. Доска отражает стадии выполнения функции: анализ, дизайн, разработка, тестирование и выпуск. Команда видит весь путь и обсуждает блокировки в одном контексте. Это не означает, что подзадачи исчезли; они просто не заменяют главный результат.
Ключевое различие проявляется в метрике. Компонентной группе легко считать число закрытых технических задач своего слоя. Feature-команде важнее время от попадания функции в бэклог до готового результата. Команда может закрывать много мелких карточек и не выпускать ни одной функции. Поэтому при сравнении структуры смотрите на Lead Time функции, а не только на продуктивность каждого подразделения.
Один вид доски не гарантирует единую ответственность. Если у функции есть карточка, но все решения по компонентам всё равно проходят через отдельные очереди и начальников, зависимость осталась. Организация должна дать группе возможность планировать общий порядок работы и договариваться о качестве результата. Иначе визуальное объединение не сократит реальное ожидание.
Рабочее пространство можно организовать так, чтобы команда видела ближайший спринт, полный бэклог и просроченные элементы, а связанные подзадачи не терялись. Но внешний вид — следствие организационного выбора. Сначала решите, кто отвечает за выпуск функции, кто имеет право менять приоритет и как команда получает помощь эксперта, затем настройте доску под эти договорённости.

Когда специализация оказывается быстрее кросс-функциональности
Перед реорганизацией спросите, много ли в вашем потоке именно пользовательских функций. Платформенная команда, которая создаёт общий API, инфраструктуру или инструменты для других разработчиков, производит иной результат. Если заставить её имитировать продуктовую feature-команду, можно потерять фокус на надёжности и архитектуре общего слоя.
Глубокая экспертиза особенно нужна при сложных технических изменениях. В ранней стадии продукта архитектура может ещё меняться; специалистам требуется изучить ограничения, прежде чем широко распределять правки между группами. В критичных компонентах количество людей, которые могут безопасно менять код, тоже ограничено. Здесь единый владелец иногда ускоряет работу, потому что предотвращает многочисленные несогласованные решения.
Другая причина для осторожности — отсутствие T-shaped специалистов. Человек может глубоко владеть своей областью и постепенно учиться соседней, но этот навык не возникает после изменения оргсхемы. Если перевести всех сразу и ожидать полноценной работы во всех компонентах, качество начнёт страдать, а каждая задача потребует больше времени на поиск контекста. Переход требует обучения и наставничества.
В некоторых сферах ответственность за компонент нельзя размыть из-за требований контроля и аудита. Feature-команда может заниматься пользовательским потоком, но изменения определённого слоя всё равно проходят проверку профильного владельца. Гибридная схема в таком случае не «неполный переход», а способ совместить скорость результата с формальной и технической ответственностью.
Поэтому правильный выбор не сводится к лозунгу «убрать все компонентные команды». Оставьте платформенные и экспертные группы там, где их результат общий для многих потоков. Ищите feature-команды там, где продуктовые функции проходят длинную цепочку передач и время ожидания стало главной потерей. В одной организации обе модели могут работать одновременно.
Пять показателей, которые покажут цену текущей структуры
Первый показатель — доля заблокированных карточек. Отфильтруйте задачи, ожидающие решения или работы другой команды, и сравните их число с активным объёмом спринта. В исходнике предложен порог около 20% как повод изучить структуру зависимостей. Это не универсальная норма: важнее, повторяется ли блокировка от спринта к спринту и сколько времени она длится.
Второй показатель — Lead Time целой функции по сравнению со временем отдельной технической задачи. Если группа быстро закрывает свой пункт, а готовая функция появляется через несколько недель, проверьте, сколько ожидания возникает между передачами. Исходный материал предлагает присмотреться к функциям, проходящим через три и более команды, когда общий путь в несколько раз длиннее локальной работы.
Третий показатель — число межпроектных зависимостей и их динамика. Отметьте связи между очередями разных технических команд за несколько циклов. Если сеть растёт, руководитель всё больше времени тратит на координацию, даже когда каждая отдельная группа соблюдает свой план. Видимость этих связей важна до того, как разговор о структуре перейдёт в спор о личной эффективности. При работе нескольких продуктовых команд общий ритм и зависимости можно проверить в пилоте SAFe.
Четвёртый показатель — возвраты карточек между командами. Когда функция несколько раз идёт из одной очереди в другую из-за интеграционных ошибок или неполного понимания результата, появляется «пинг-понг». Посмотрите историю самых долгих элементов: кто возвращал работу, почему и могла ли совместная проверка раньше снять проблему. Один возврат бывает нормальным; повторяющийся рисунок указывает на разорванную ответственность.
Пятый показатель — разрыв между бизнес-приоритетом и техническими очередями. Возьмите несколько важнейших функций из продуктового бэклога и проверьте, где стоят их части у компонентных групп. Если ключевая функция ждёт, пока техническая команда выполняет менее значимую для бизнеса работу, общая цель не управляет реальным порядком. Это может требовать изменения приоритизации, а не обязательно полной реорганизации.
Оценивайте показатели вместе. Одна проблема может решаться уточнением процесса передачи или общим правилом приоритета. Если несколько разных сигналов одновременно говорят о длинных ожиданиях, пилот feature-команды становится разумной гипотезой. Исходные пороги служат ориентирами для обсуждения; результат проверяется на своём потоке задач.
Показатели должны помогать искать причину, а не выставлять оценки людям. Карточка может ждать из-за внешнего согласования, нехватки редкого специалиста или слишком крупного объёма. Разберите несколько конкретных цепочек от запроса до выпуска. Тогда руководитель увидит, что изменит новая структура и какие потери она не устранит. Для наблюдения за ожиданием пригодится подход из статьи о Kanban и метриках потока.
Как может проходить переход без остановки разработки
Исходный материал описывает иллюстративный сценарий для организации примерно из 40 разработчиков. На старте пять компонентных команд обслуживают интерфейс, серверную часть, тестирование и общие процессы. Функции проходят через несколько очередей, и менеджер много времени тратит на согласование зависимостей. Числа такого сценария нельзя считать прогнозом для другой компании; полезна последовательность действий.
В первый месяц сформируйте маленькую пилотную группу из добровольцев, представляющих основные навыки потока. Выберите одну продуктовую область, которую она сможет вести от анализа до проверки. Остальные команды продолжают работу по прежней схеме: организация не должна останавливать текущие обязательства ради эксперимента. Пилот получает собственный бэклог функций и понятные границы ответственности.
Первые недели уйдут на изучение соседних компонентов и рабочих привычек. Разработчик интерфейса впервые глубже посмотрит на серверную логику, специалист по тестированию включится раньше последнего этапа, команда договорится о критериях готовности. Это временное замедление не следует маскировать. Запишите исходное время доставки функции и долю блокировок, чтобы оценить результат после нескольких циклов.
В следующие месяцы проведите перекрёстное обучение: совместную разработку, проверку кода специалистами разных профилей и короткие технические сессии. Цель не в полном обмене профессиями. Участники должны достаточно понимать смежный слой, чтобы быстрее обсуждать изменения и не ждать другого отдела из-за простой правки или вопроса. Отдельно изучите, какие компоненты чаще всего создавали прежние блокировки, и направьте обучение туда.
Если пилот снижает ожидание без потери качества, можно сформировать следующую feature-команду. В описанном источником сценарии через несколько месяцев появились три продуктовые группы и сохранилась отдельная платформенная команда для инфраструктуры и общих сервисов. Это важная часть результата: организация не отказалась от специализации, а разместила её там, где она обеспечивает все продуктовые потоки.
Проверяйте не только скорость. Доля заблокированных карточек и Lead Time функции покажут движение, но также нужно смотреть на дефекты, перегрузку специалистов и состояние общих компонентов. Если ускорение достигнуто за счёт скрытого технического долга, эффект неустойчив. Руководитель должен видеть цену изменений так же ясно, как и обещанную выгоду.
Шесть шагов для пилота feature-команды
Первый шаг — аудит зависимостей за несколько последних спринтов. Найдите, какие компоненты и решения чаще всего блокируют функции. Посмотрите путь нескольких конкретных запросов и отметьте время ожидания между командами. Аудит помогает выбрать поток для пилота и не пытаться лечить оргструктурой проблему, которая на самом деле связана с неясным описанием задачи.
Второй шаг — выбрать продуктовую область с понятной границей. Она должна быть достаточно значимой, чтобы изменение можно было измерить, и достаточно обозримой, чтобы новая группа не зависела от всех технических отделов сразу. Если поток особенно сильно страдает от передач, это хороший кандидат; если он полностью завязан на редкий внешний ресурс, пилот может не показать эффект новой структуры.
Третий шаг — сформировать команду из людей, готовых учиться смежной работе. Минимальный состав в примере источника включает специалистов по интерфейсу, серверной части и тестированию; доступ к дизайну и платформе организуют по потребности. Не превращайте участие в наказание или обязательный перевод без разговора. Добровольность помогает начать с тех, кто готов пересматривать прежние границы работы.
Четвёртый шаг — дать пилоту одно рабочее пространство и бэклог пользовательских историй. Внутри карточки оставьте технические действия, но её главный результат должен быть виден целиком. Стадии доски отражают путь функции от анализа до проверки. Тогда группа на ежедневном обзоре обсуждает одну поставку, а не только закрытие отдельных технических пунктов.
Пятый шаг — перекрёстное обучение и поддержка экспертов. Совместная работа над кодом, ревью, документация и технические консультации нужны с первого цикла. Руководитель должен выделить на это время, иначе вся новая компетенция будет осваиваться ночами поверх прежней нагрузки. Роли внутри команды распределяют по реальным навыкам, а не по ожиданию, что все теперь одинаково универсальны.
Шестой шаг — после каждого цикла сравнивать пять показателей и качество результата. Если пилот стал быстрее завершать функции и снизил число передач без ухудшения надёжности, можно масштабировать подход на следующий поток. Если нет, разберите причины до расширения. Платформенные команды при этом продолжают обслуживать общую инфраструктуру как внутренний сервис с ясным порядком запросов.
Такой переход сохраняет текущую разработку. Он меняет один поток, измеряет эффект и только потом переносит проверенные правила дальше. Команде легче принять структуру, когда она видит конкретное изменение в работе, а не только новую схему подчинения.

Риски feature-модели и как сохранить экспертизу
Первый риск — размывание глубокого владения компонентом. Если разные продуктовые группы независимо меняют общий модуль, архитектурные проблемы могут накапливаться незаметно. Нужны профильные сообщества специалистов, регулярные технические обсуждения и понятный порядок важных изменений. Результатом встречи должен быть конкретный артефакт: решение по архитектуре, правило ревью или обновлённая инструкция.
Второй риск — рост когнитивной нагрузки. Участникам приходится понимать больше смежных частей системы и последствия своих правок. Без актуальной документации люди тратят рабочее время на восстановление контекста. Поддерживайте короткие описания компонентов, историю решений и схемы, к которым можно обратиться во время задачи. Обучение не должно зависеть только от присутствия одного опытного сотрудника.
Третий риск — иллюзия полной автономности. Даже сильная feature-команда пользуется общими сервисами, библиотеками, инфраструктурой и дизайн-системой. Если эти направления обслуживаются по остаточному принципу, группы начинают делать собственные копии решений. Организация получает несколько несовместимых способов выполнять одну операцию. Платформенная группа и ясный порядок совместной работы защищают от такого размножения.
Четвёртый риск — социальное сопротивление. Специалист, годами развивавший важный компонент, может услышать в реорганизации мысль, что его опыт больше не нужен. Объясните, где эта экспертиза останется критичной: архитектурное наставничество, ревью общих компонентов, помощь нескольким feature-командам. Переход не должен обесценивать профессиональную глубину ради нового названия команды.
Каждый риск требует времени и ответственности. Нельзя одной командной встречей создать документацию, выстроить инженерные стандарты и договориться о новых ролях. Включите эти работы в план перехода и проверяйте их так же регулярно, как скорость выпуска функций. Быстрый Lead Time не компенсирует долгосрочную потерю надёжности системы.
Ответы на вопросы перед сменой структуры
Что такое компонентная команда? Это группа, которая отвечает за техническую часть системы или общую платформенную возможность. Она получает запросы от разных продуктовых потоков и поддерживает качество своего компонента. Такая ответственность полезна там, где нескольким feature-командам нужен один надёжный сервис.
Могут ли обе модели работать в одной организации? Да. Продуктовые группы ведут пользовательские функции целиком, а платформенные и экспертные группы поддерживают общую инфраструктуру. Гибрид помогает убрать лишние передачи в продуктовой работе, сохранив глубокую специализацию там, где она нужна.
Какой размер команды выбрать? В исходнике ориентиром названы пять–семь человек, но точное число зависит от потока и доступных навыков. Группа должна быть достаточно устойчивой, чтобы отпуск одного участника не останавливал всю работу, и достаточно компактной для прямых договорённостей. Если для выпуска функции ей всё равно постоянно нужны пять внешних отделов, состав или границы пилота требуют пересмотра.
Сколько длится переход? Небольшую пилотную группу можно организовать за несколько недель, а первые выводы получить после нескольких рабочих циклов. Полная перестройка большой организации займёт существенно больше времени, потому что меняются навыки, бэклог, ответственность и инженерные правила. Оценивайте не дату переименования команд, а момент, когда функции действительно перестали ждать прежние очереди.
Начните с карты зависимостей и пяти показателей. Если несколько сигналов одновременно указывают на большие потери при передачах, выберите один продуктовый поток для пилота. Если проблема локальна, попробуйте исправить приоритеты или правила взаимодействия без общей реорганизации. Цель — быстрее и надёжнее доводить нужный результат до пользователя, а не доказать правоту одной организационной модели.
Разложи работу команды по проектам и задачам в NUBL. Отметь блокировки и связи между группами, чтобы увидеть, где структура помогает выпускать результат, а где создаёт ожидание.